Por Que 74% do Código Escrito por IA Exige Revisão
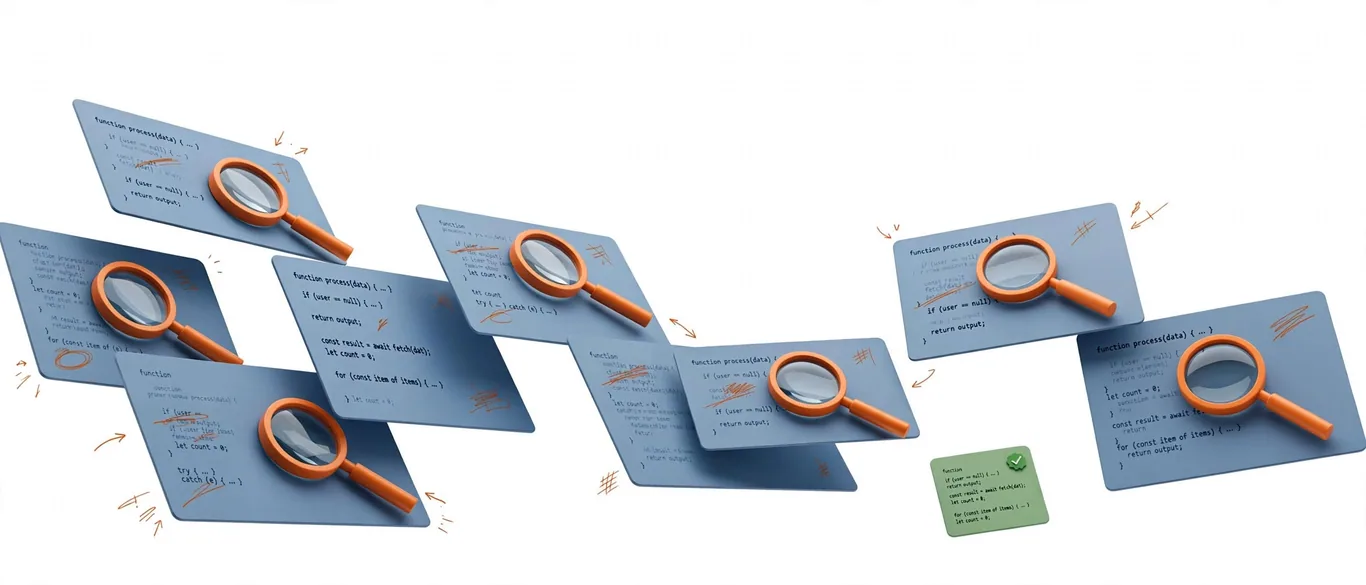
Os testes tradicionais de programação costumam pintar um cenário perfeito. Quando os modelos rodam em ambientes controlados como o WebCompass-edit, atingem pontuações superiores a 99%. No entanto, o desenvolvimento de software real envolve requisitos entrelaçados e imprevistos diários. De acordo com uma apuração do The Decoder, um novo benchmark chamado Co-Design Bench revela uma lacuna de mais de 35 pontos percentuais entre as notas teóricas e a usabilidade prática.
Por que os modelos de ponta falham em tarefas reais?
Desenvolvido por pesquisadores da Alibaba e de universidades asiáticas, o novo teste utiliza solicitações reais de alteração feitas por usuários, incluindo casos em que comandos precisaram ser reescritos ou revertidos. Mesmo o melhor modelo avaliado, o GPT-6 Astra, concluiu com 100% de correção apenas 26,4% das tarefas. Embora cumpra cerca de 70% dos requisitos em média, o agente invariavelmente deixa algum detalhe quebrado, exigindo intervenção humana.
O principal calcanhar de Aquiles dos agentes é a sobreposição de exigências. O desempenho despenca em todos os modelos quando uma única tarefa exige três ou quatro tipos diferentes de alterações simultâneas — como ajustes de layout, design, interatividade e lógica de conteúdo. Além disso, gastar mais capacidade de processamento (tokens) não resolveu essa fraqueza de forma consistente.
Como o ambiente de execução altera o resultado?
A pesquisa também demonstrou que o programa que intermedia a leitura e execução de código pelo agente — conhecido como harness — impacta o resultado final tanto quanto o próprio modelo de IA. O modelo Qwen3.8-27B, por exemplo, oscilou entre 75% e 56% de ac Aproveitamento dependendo estritamente do ambiente em que rodava. Isso prova que rankings focados apenas no modelo isolado contam apenas parte da história.
Passo a passo: como avaliar agentes de código na sua equipe
Desconfie de placares isolados: Altas pontuações em testes como o SWE-bench Verified superestimam a produtividade real em até 24 pontos percentuais, segundo dados de organizações de pesquisa.
Teste o conjunto completo: Ao contratar ou adotar um assistente de IA, avalie tanto o modelo quanto o ambiente de execução acoplado a ele dentro da sua base de código real.
Planeje tempo para code review: Conte com a revisão humana obrigatória para finalizar detalhes e corrigir falhas deixadas em tarefas complexas.
Veredito: vale a pena usar agentes de IA na programação?
Os agentes continuam excelentes para gerar rascunhos rápidos, estruturar scripts básicos e acelerar tarefas repetitivas isoladas. Contudo, esperar autonomia completa em grandes refatorações é um atalho para frustrações. Equipes de engenharia devem encarar essas ferramentas como assistentes júnior eficientes para o trabalho pesado, mantendo o controle total da revisão e da arquitetura nas mãos humanas.
Fontes
Perguntas frequentes
- O que é o Co-Design Bench?
- É um novo benchmark de programação criado por pesquisadores da Alibaba que utiliza solicitações reais de usuários para testar a verdadeira eficácia de agentes de IA.
- Qual é a taxa de acerto real dos modelos de IA?
- Segundo dados divulgados pelo The Decoder, o modelo mais avançado avaliado (GPT-6 Astra) resolve completamente apenas 26,4% das tarefas reais sem falhas.
- Por que os testes tradicionais falham em prever o desempenho?
- Benchmarks antigos usam tarefas isoladas onde a IA consegue verificar o próprio código, enquanto o mundo real exige lidar com múltiplos tipos de alterações simultâneas.
Resumo de IA em 3 minutos
Receba grátis o que realmente importa em IA e tecnologia, direto no seu e-mail. Sem spam, cancele com 1 clique.
Comentários
0 comentáriosDeixe seu comentário
Seja o primeiro a comentar.
Continue Lendo
Por Que Auditores de IA Estão Gerando Alertas Falsos Demais
Auditores de IA geram alarmes falsos excessivos
Novo Modelo Aberto da Ex-CTO da OpenAI Vale a Pena?
Thinking Machines lança Inkling 2 Small
IA Corta 80% da Fila de Fraudes e Nubank Demite Analistas
Nubank demite funcionários após IA automatizar fraudes